
我在八月忙碌的是,製作台股、美股財報 RAG 產品雛形,增加自己的企業級隱私產品開發經驗,自己使用,也探索本機模型的能力發展到什麼程度。它內建向量搜尋資料的能力,也提供問答介面,Repo 放在 GitHub,歡迎試用,須具備自行除錯和輸入指令的能力。
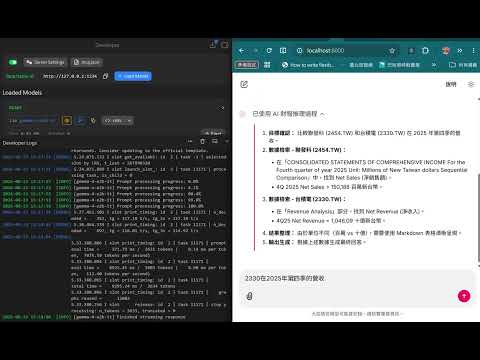
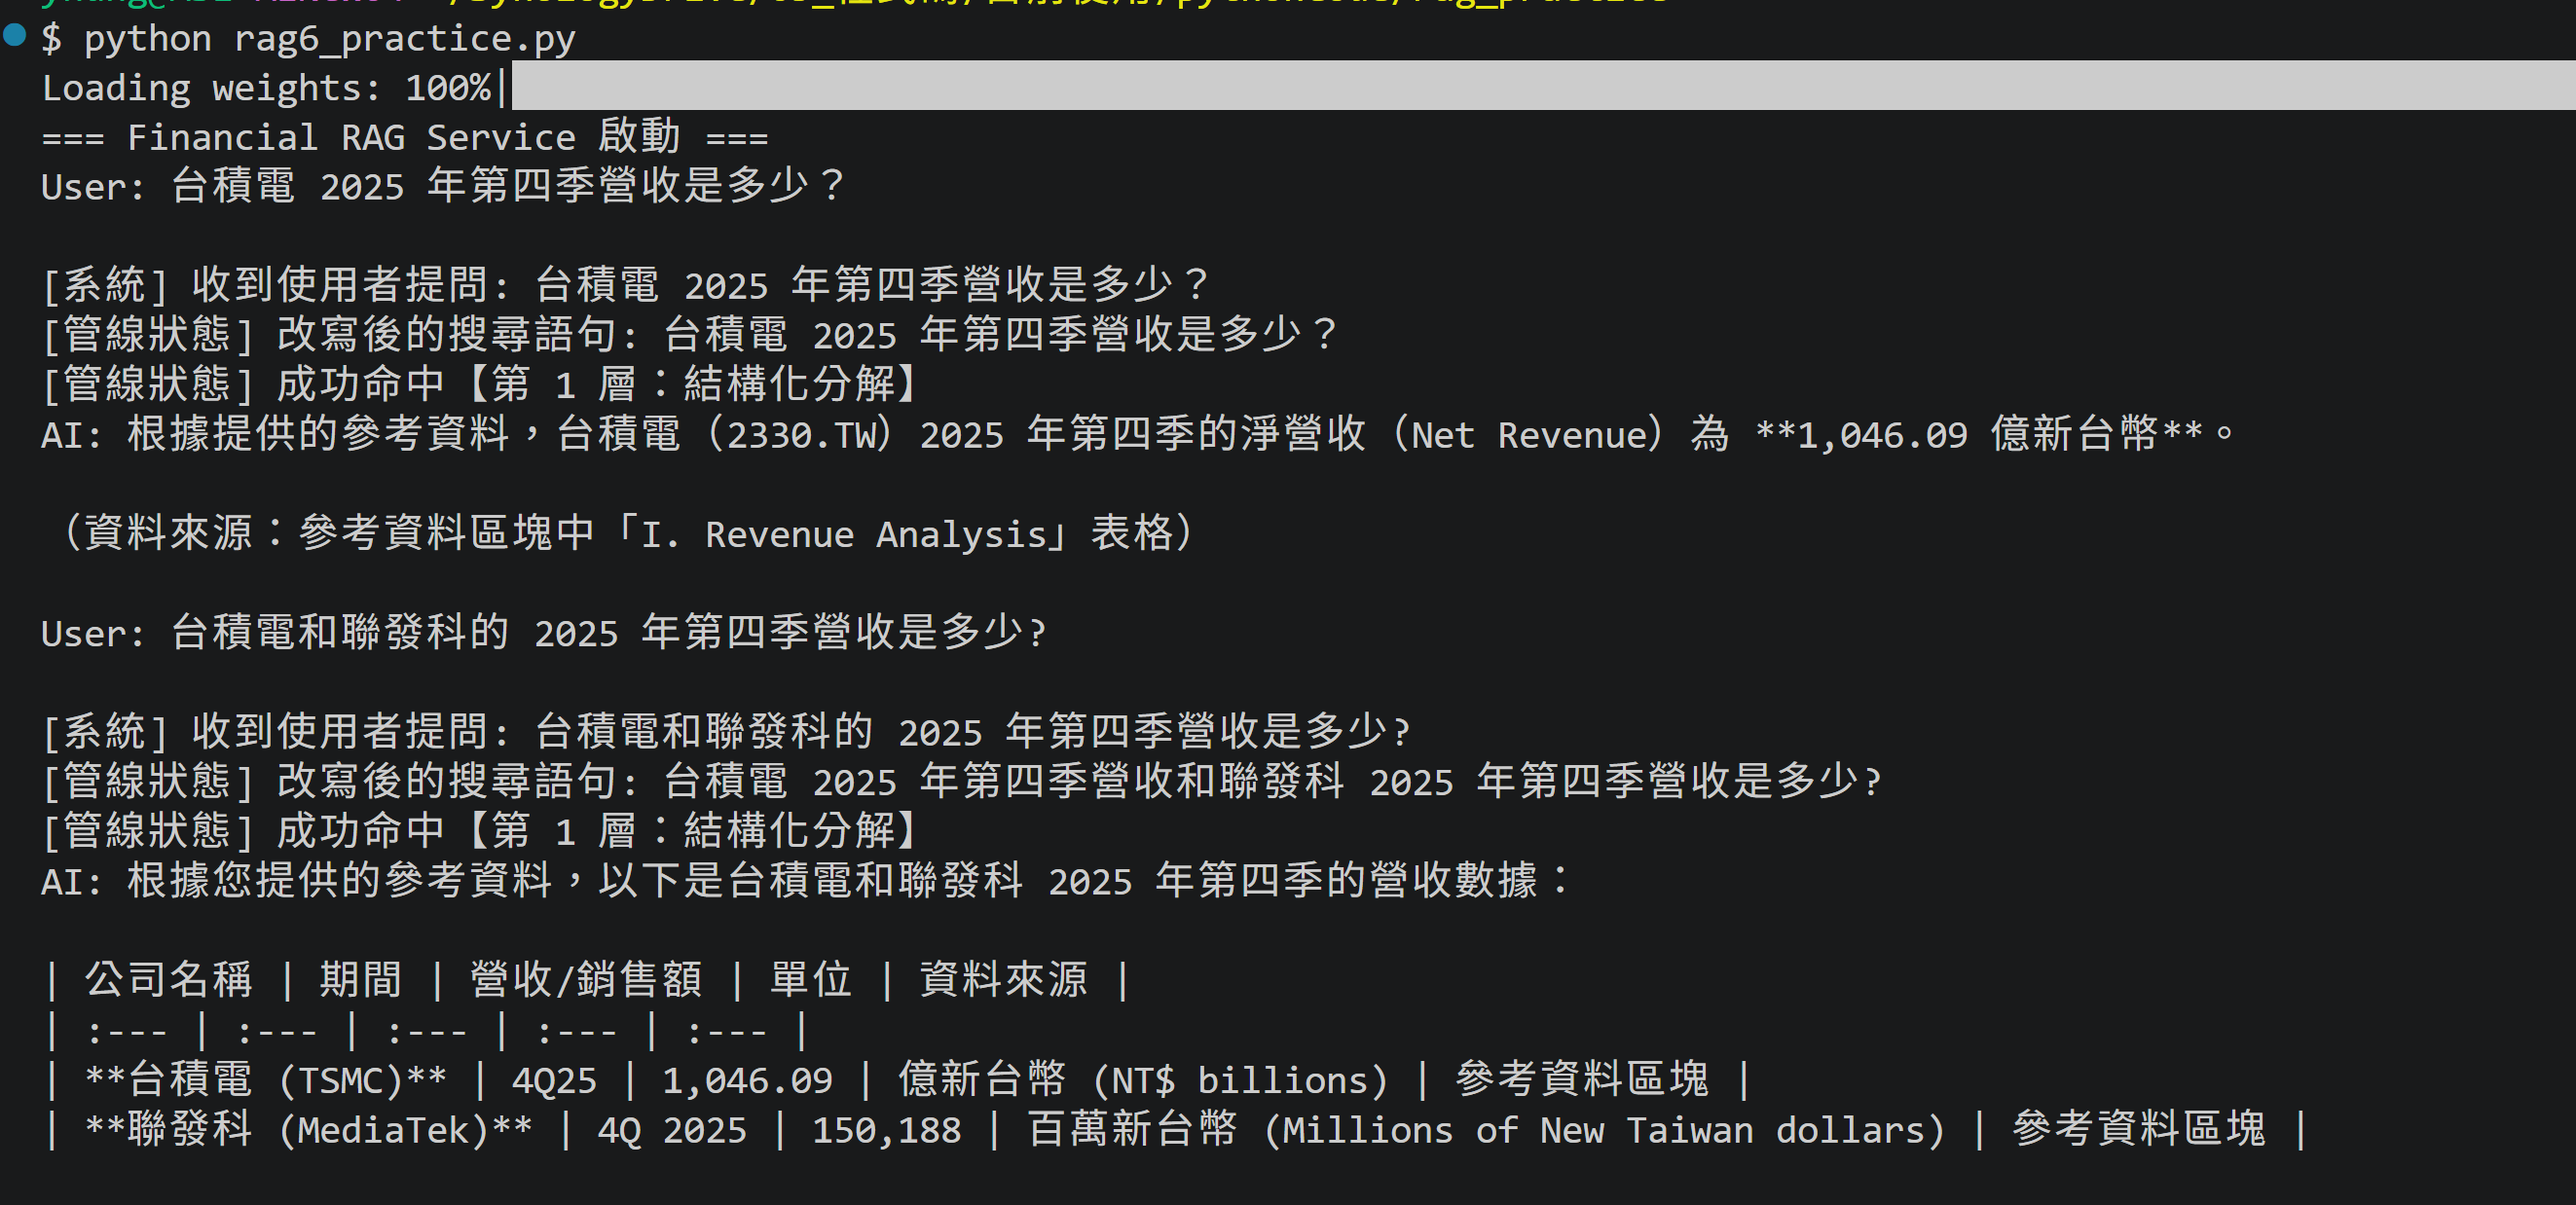
因為是本機運作,所以你需要有:
pip install -r requirements.txtfinancial_ingestion_advanced.py 檔案執行,財報名稱建議是 股票代號_年度第幾季 的格式,例如 2330_25Q4.pdf,請查看檔案 financial_ingestion_advanced.py 的最後幾行去設定。啟用對話介面的指令是 chainlit run app.py -w
我問雲端 LLM 服務很多輪,加上我的工程經驗,RAG現階段我實作的功能有:
financial_ingestion_advanced.py ,將財報 pdf 檔案向量化與儲存到資料庫。
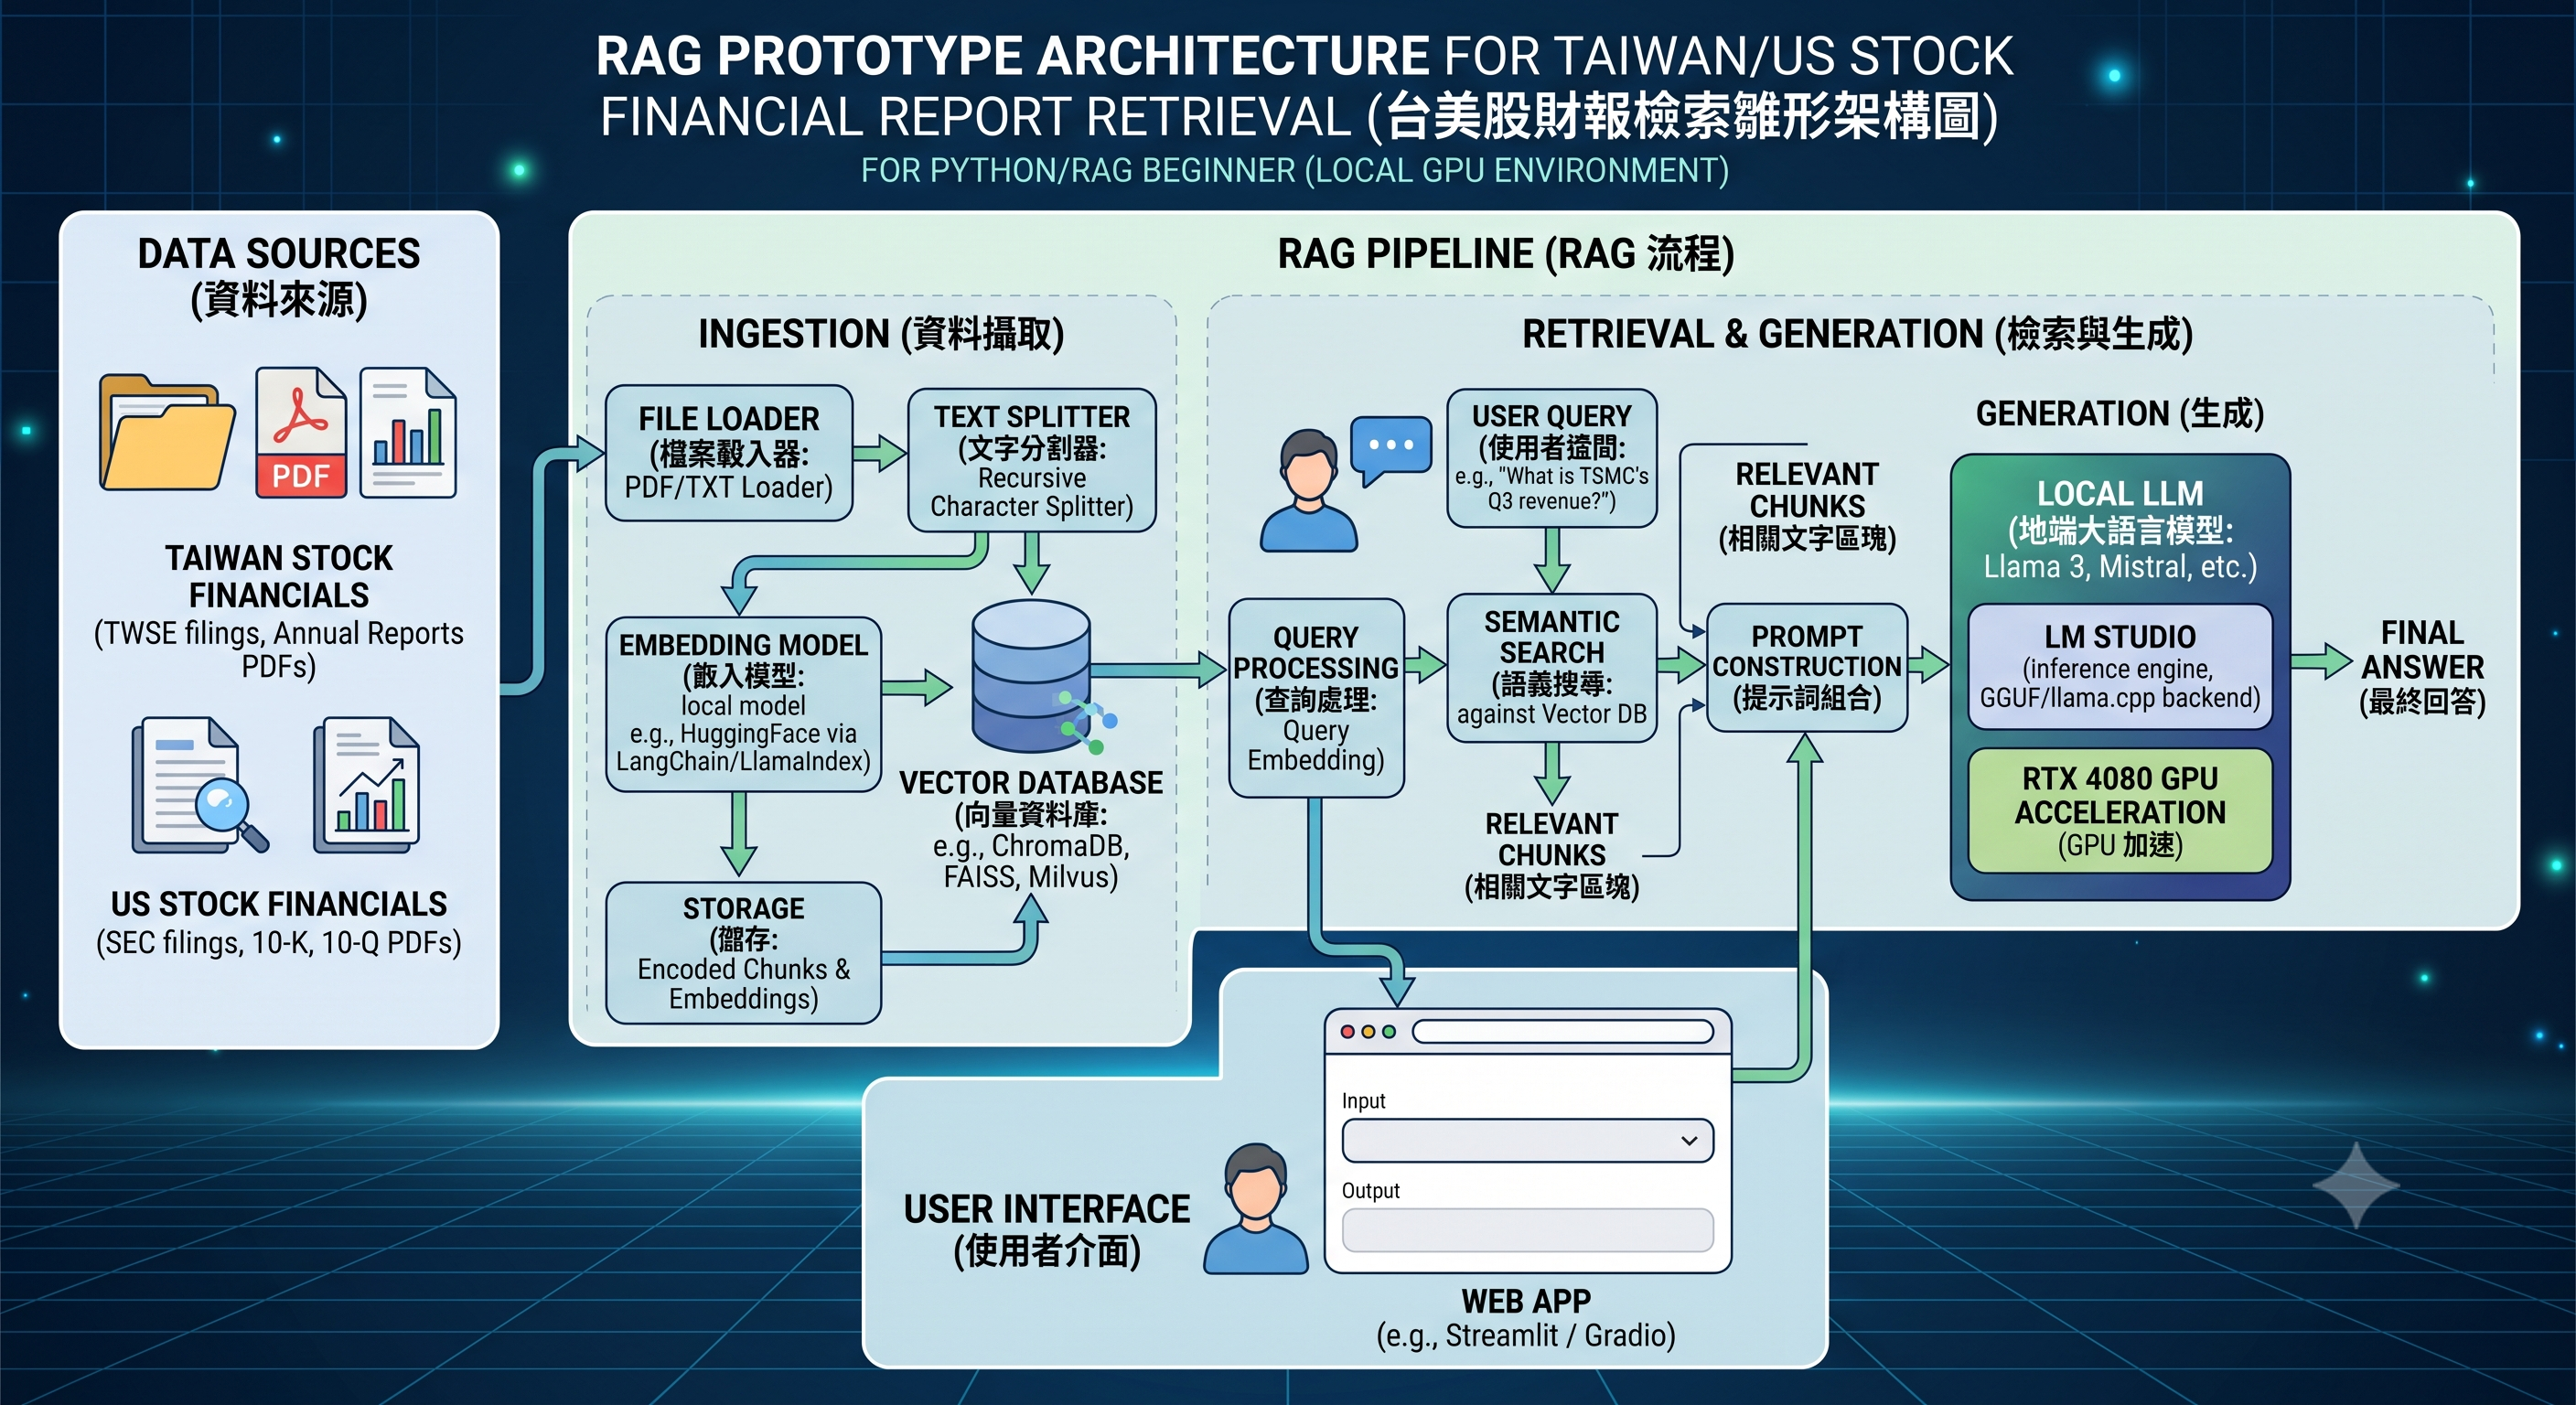
架構圖是

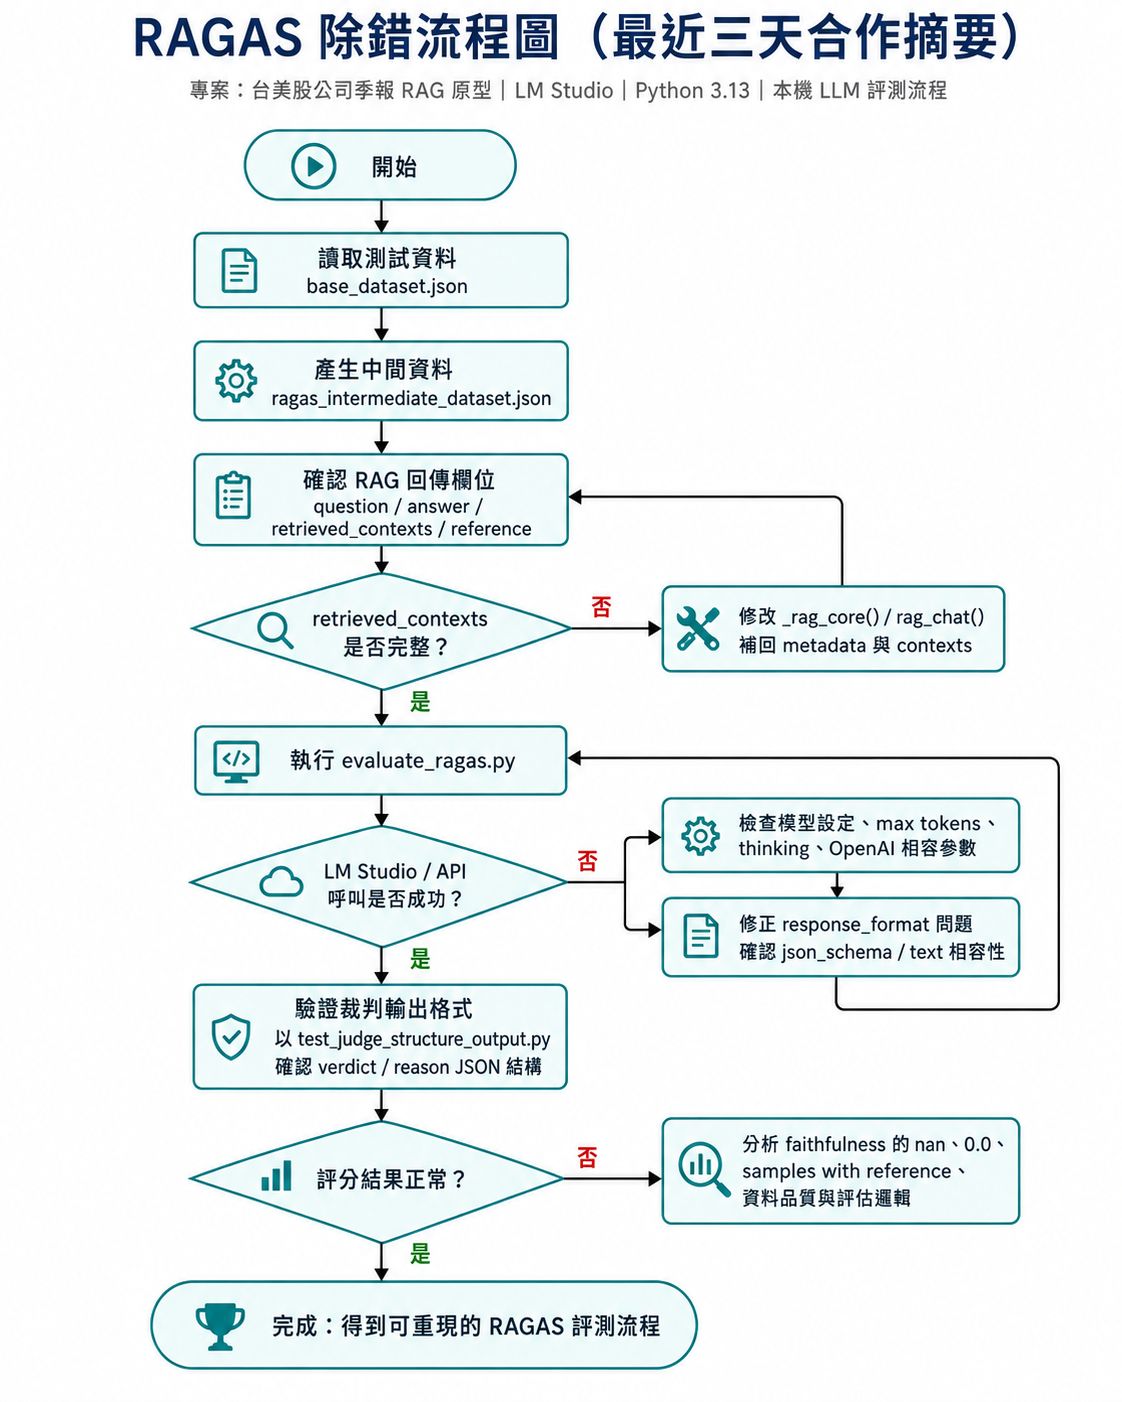
做完 RAG 產品後,我認為不能只有自己認為 RAG 回答品質好就足夠了,應該要有客觀評價指標或工具可以表達,所以我找到 RAGAS 評價軟體來做這件事。 但是使用 RAGAS 軟體沒有這麼簡單,因為它近期版本的相關套件相依性有問題,無法容易解決,不能單純用降軟體版本的方式處理。過程中,我加很多 workaround 和 debug message,定位原因後,已經清除乾淨。遇到的錯誤有: RAGAS 套件相依性、 LM studio 提供的 OpenAI-compatible API 的 Structured output 的 http 400 問題、Faithfulness check 遇到 NaN、0.0問題,所以再接著往上下游找沒收到正確的 MetricResult 資訊問題、reference coverage、retrieved contexts 與 Judge 輸出、token maximum、啟用 thinking 問題。最終做出 RAGAS assessment pipeline。
如果包含除錯 RAGAS 軟體的過程,如以下的文字流程圖:
原始 Financial RAG
        │
        ▼
修改 _rag_core()
讓 Retriever 結果可被取得
        │
        ▼
建立 retrieved_contexts
        │
        ▼
base_dataset.json
        │
        ▼
執行自己的 RAG
        │
        ▼
ragas_intermediate_dataset.json
        │
        ▼
RAGAS
        │
        ▼
Local Judge LLM
LM Studio / OpenAI-compatible API
        │
        ├── Structured Output 400 Error
        │          ↓
        │   隔離 Judge 測試
        │          ↓
        │   verdict / reason JSON 成功
        │
        ├── Thinking / max token 問題
        │          ↓
        │   LM Studio 設定驗證
        │
        └── Faithfulness nan / 0.0
                   ↓
            MetricResult 分析
                   ↓
           reference / samples 檢查
                   ↓
        可重現的 RAGAS 評估流程
我未來預計增加 Agentic RAG 功能。